<aside> 🤩 博客地址:nicooo-wang.github.io
</aside>
不知道你有没有测试过手写pytorch做LLM的推理,或者我猜更多人用的是 Hugging Face Transformers 做推理,如果详细分析过性能数据,可能会发现一个尴尬的现象:GPU 显存占用很高,但实际利用率却时高时低,吞吐量也上不去。这不是你的代码有问题,而是传统推理方式本身就存在几个根本性的局限。
痛点一:KV Cache 的显存碎片化
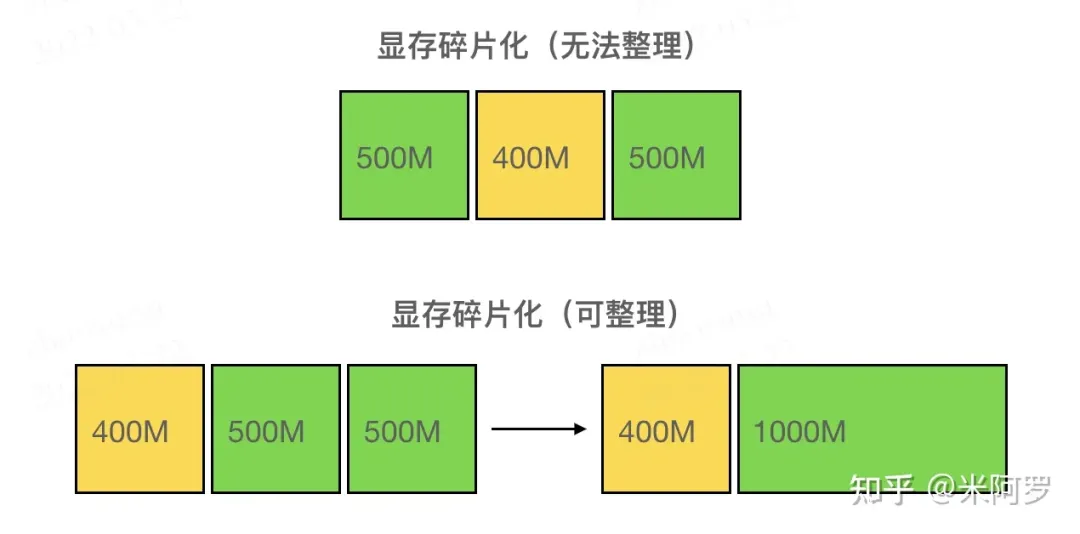
在llm 推理过程中,每个 token 都会生成对应的 Key 和 Value 向量,这些缓存需要保存在 GPU 显存中。传统方法为每个请求分配一块连续的内存空间。
问题在于,当某些请求完成并释放内存后,会在显存中留下不连续的"空洞"。新来的请求如果需要比这些空洞更大的连续空间,就无法利用这些已释放的内存——这与早期操作系统面临的内存碎片化问题如出一辙。
痛点二:静态批处理的低效
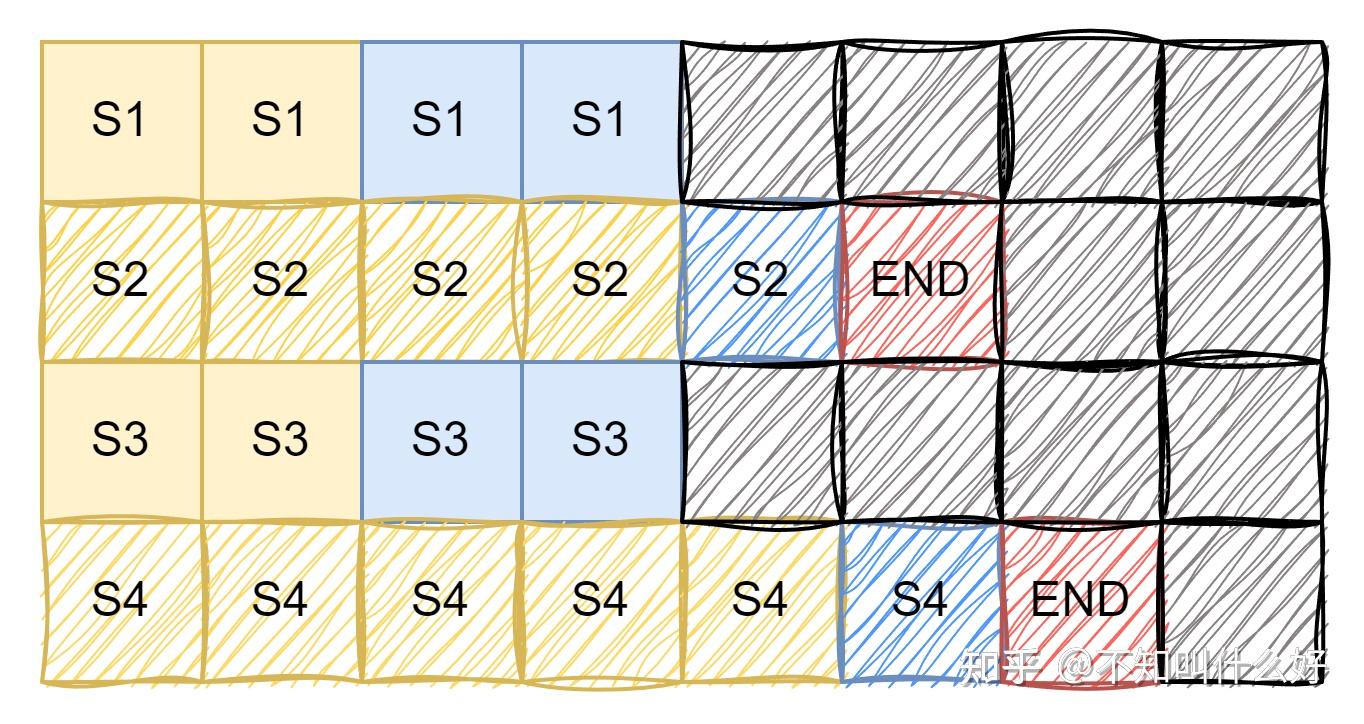
传统的批处理方式是"静态"的:凑齐一批请求,等整个 batch 全部完成,再接收下一批。问题是,不同请求的输出长度差异可能非常大——有的请求生成 10 个 token 就结束了,有的要生成 500 个。
这导致了一个荒谬的局面:先完成的请求不得不"陪跑",占着显存干等其他请求。GPU 利用率随着请求逐个完成而不断下降,直到整个 batch 结束后才能恢复。
痛点三:预分配造成的浪费